

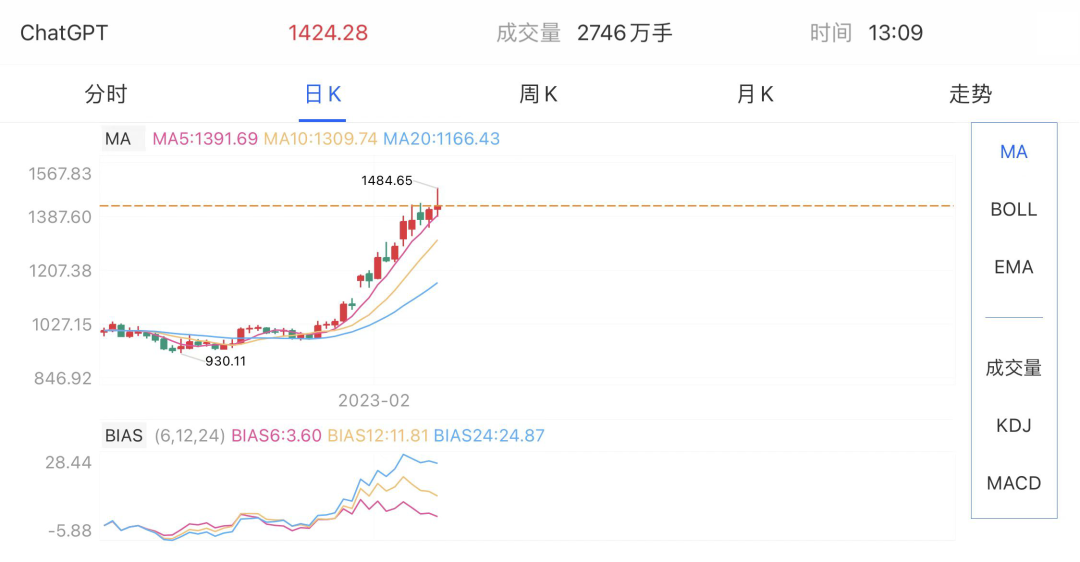
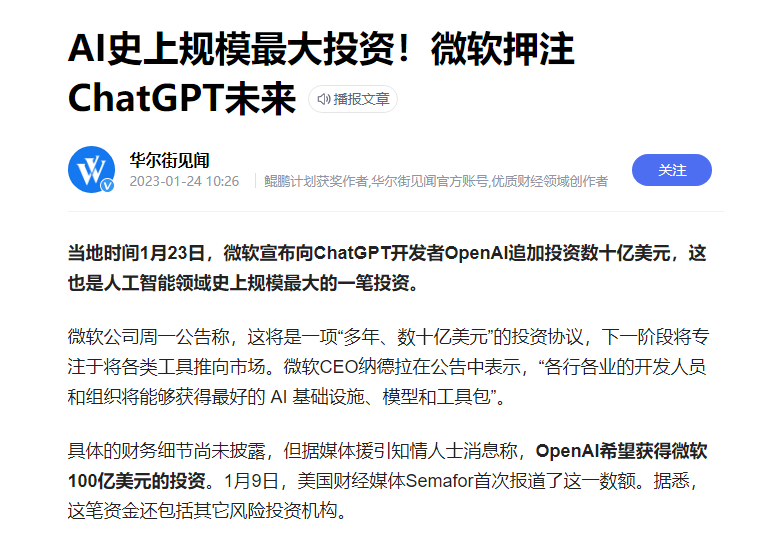
近期,OpenAI研发的聊天机器人ChatGPT程序火爆全球,仅用两个月的时间,ChatGPT 的活跃用户就已经破亿,甚至直接取代了前段时间热投的Web3和NFT,OpenAI的股价也直接翻了几番。
世界上公认顶尖的AI Labs包括:Google(DeepMind)、Mate(Fair)、OpenAI(ChatGPT)。
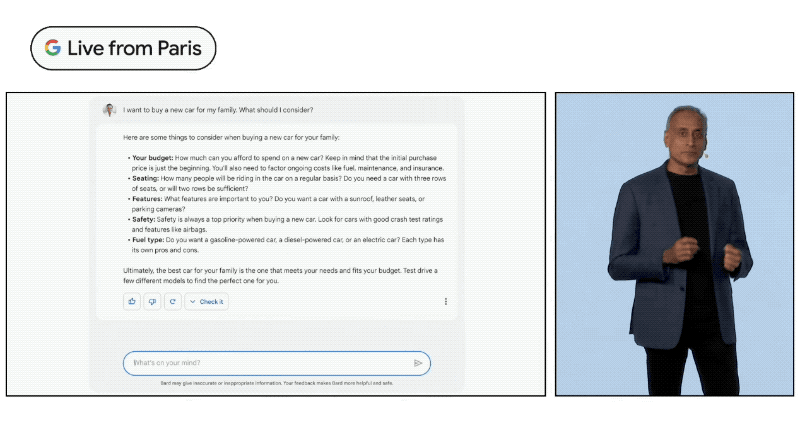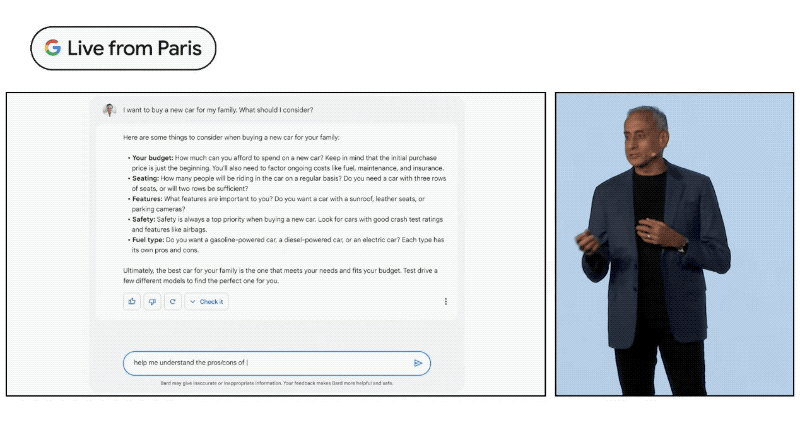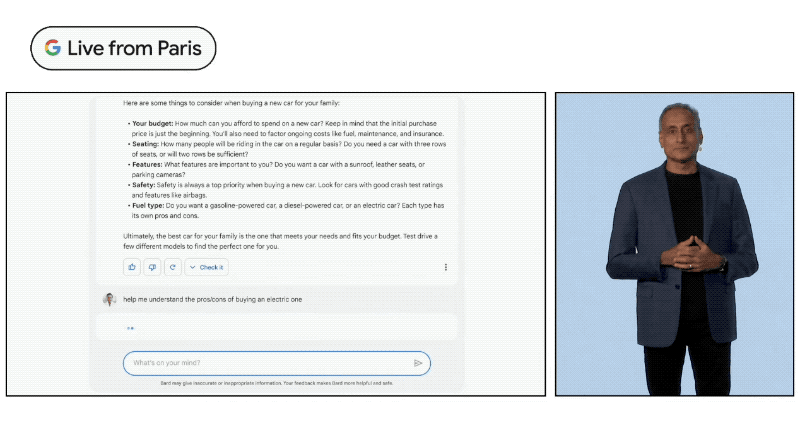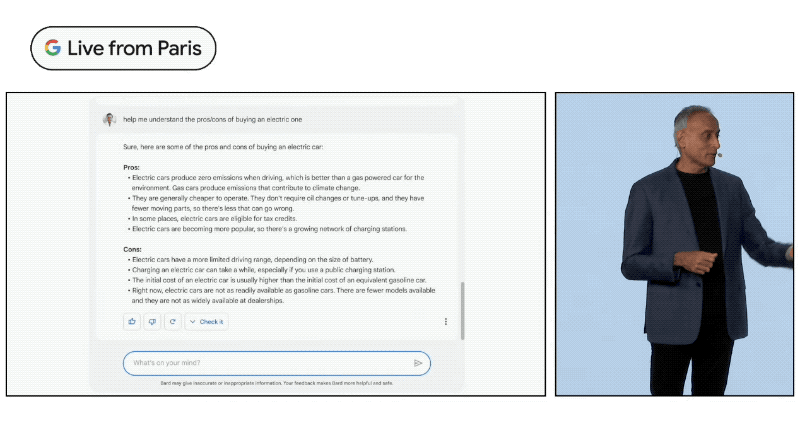
比较巧的是Google的聊天机器人Bard最近在一次演示中出现回答错误,导致Google母公司Alphabet市值蒸发1000亿,而Mate最近正沉迷于元宇宙的世界中无法自拔。
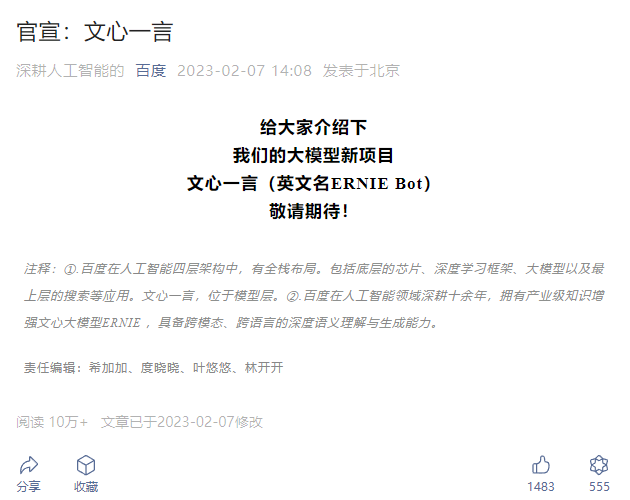
与此同时,国内的各个巨头也纷纷将早已布局的产品加入战线,如百度的“文心一言”(ERNIE Bot)项目,已官宣会在三月份完成内测并面向公众开放,这无疑是百度最好的机会。
“项目的成功不可复制,但能超越”,说到这儿,但如果国内巨头公司没有提早布局的话,依靠我们擅长的对产品的快速复制能力复制出一个新“ChatGPT”,能够实现吗?
阻力/因素
技术与方向
百度、阿里、腾讯、京东、网易等大厂均已涉足类似ChatGPT和AIGC项目,但大部分都是细分场景下的产物,比如阿里的产品将会应用于产品中、京东的产品将会应用于服务中、有道将投入到教育场景中,相对于大而全的模型来说,他们更倾向于向对自己行业有帮助的领域开刀。
成本高昂
ChatGPT仅在大语言模型的单次训练硬件成本就已突破3000万元人民币,加上投入到其中的人力、超大量的训练成本等,可能需要“挥霍”上百亿美元,才能与其进行竞争并在竞争中有所成绩。
语言文化差异
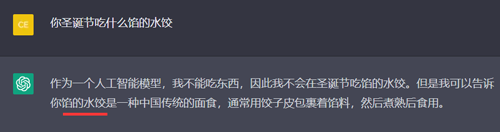
根据语言来看,英语属于解释性语言,组成简单,且在日常使用中,想到什么就直接表达,基本是定数;而中文是象形词,一个字、一个词分别都有好几种意思,对话模型中没有英文容易理解。且在表达中此类机器人的语言大模型是无法进行控制的,它的回答是否合适、是否涉及敏感?是否会受到影响有一定的意识形态?这些都是需要提前考量的。人为控制的平台都经常出现“已过滤不当言论,部分评论暂不展示”的场面,如果ChatGPT的回答中也来一句同样的话,估计会有些奇怪吧。
法律风险
如国产ChatGPT在回答中是否要有相应的知识产权?如何降低虚假信息传播风险?海量的数据提供给ChatGPT学习、回答,如有用户将一些个人数据或具有商业秘密的信息输入,它是否会将其纳入自己的资料库匹配式泄露?如受版权保护的文本、代码、作品在其回答中出现,不管直播还是篡改,够有可能损害原作者的著作权,该如何保护?
除上述的技术、资金、语言、法律风险等问题,还有人性与技术氛围方面的影响。
所以对中国来说就做不了ChatGPT了?不,由于上面的复杂因素影响,中国后续只会依靠我们的优势做出更聪明、更智能的。我们有着全球最庞大的网民群体,在“中国企业家”手中的数据都数不胜数,更别说集合起来了,庞大的大数据估计在全球都独占鳌头。只要他们能造出来,我们就能造出更好的,起步晚并不意味着我们落后,而是在一些领域,我们不擅长领跑。